
三维重建(一):相机投影、对极几何与三角化
这个系列以法国 Sceaux 城堡的 11 张照片为线索,回顾从二维观测恢复三维结构的基本方法。我们始终沿着同一条计算链前进:先建立相机投影,利用对应点约束相机之间的运动,再恢复空间点,最后把这些离散观测扩展为表面。这样,特征匹配、Structure from Motion(SfM)、束调整与 Multi-view Stereo(MVS)就能放在同一套几何语言里理解。
照片和完整场景结果来自固定版本的 OpenMVS 官方示例。正文给出继续阅读所需的定义和结论;较长的线性代数与推导放在可折叠部分,跳过它们也能沿着案例读完。
1. 从重建结果回到图像观测
滚动到这里时加载交互图。
静态预览/加载失败时查看
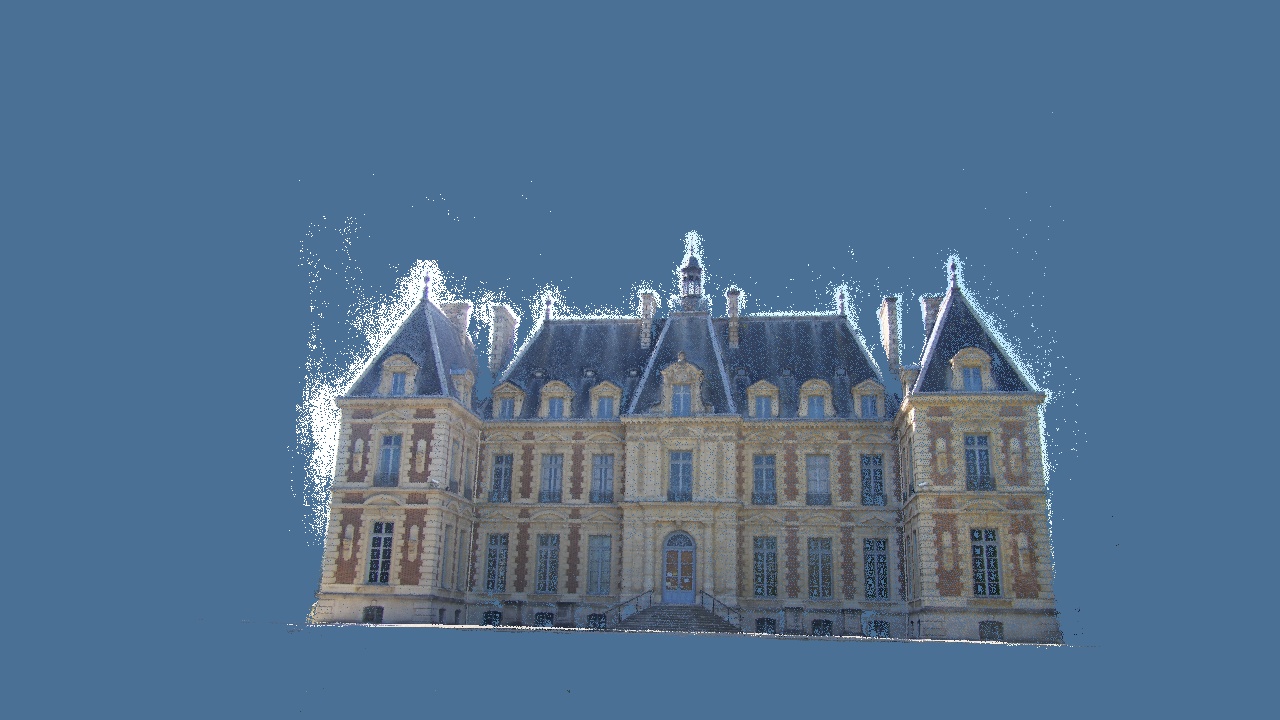
从正面切换三个阶段,可以看到窗框和屋顶首先在稀疏点中出现,随后墙面逐渐连续,最后被组织成三角形表面。略微转动视角,中央门洞与窗沿的前后层次就比单张照片更清楚。这个层次正是重建需要恢复的空间关系。
设门框上的一个固定位置为三维点 \(\mathbf X\),它在第 \(i\) 张照片中的像素观测为 \(\mathbf p_i=(u_i,v_i)^\top\)。输入只有这些图像位置及其附近的外观;输出需要包含相机的标定、拍摄位姿和三维点。单张照片把一条视线上的许多位置压到同一个像素,多个观察位置则使这些可能位置受到共同约束。
这个案例的上游结果包含 20,951 个稀疏点、425,342 个稠密点,以及 244,247 个网格三角形。网页保留完整稀疏点和网格,将稠密点按文件顺序均匀抽样到 65,000 点。三个阶段采用相同的显示坐标变换,便于比较;它们的数量反映各阶段的表示方式,不能直接作为精度指标。
2. 相机坐标、透视投影与标定
我们统一使用列向量。\(\mathbf X\in\mathbb R^3\) 表示世界坐标中的点,第 \(i\) 台相机用世界到相机的变换表示:
\[\mathbf X_i=R_i\mathbf X+\mathbf t_i, \qquad R_i\in SO(3).\]\(R_i\) 是旋转,\(\mathbf t_i\) 是这个坐标变换中的平移。相机中心在世界坐标中记为 \(\mathbf C_i\),满足 \(R_i\mathbf C_i+\mathbf t_i=0\),因此
\[\mathbf C_i=-R_i^\top\mathbf t_i.\]这一区别会直接影响文件导入:把 \(\mathbf t_i\) 当作相机在世界中的位置,会得到错误的相机布局。
对于已去畸变的针孔图像,令 \(\tilde{\mathbf p}_i=(u_i,v_i,1)^\top\),投影写成
\[Z_i\tilde{\mathbf p}_i=K_i\mathbf X_i, \qquad K_i=\begin{pmatrix} f_{x,i}&0&c_{x,i}\\ 0&f_{y,i}&c_{y,i}\\ 0&0&1 \end{pmatrix}.\]这里采用零斜切的常用相机模型。\(f_x,f_y\) 是以像素计的焦距,\((c_x,c_y)\) 是主点,\(Z_i\) 是相机坐标的第三分量。将第三分量除掉,就得到熟悉的透视关系 \(u=f_xX_i/Z_i+c_x\)、\(v=f_yY_i/Z_i+c_y\)。世界坐标先通过外参进入相机坐标,再通过内参进入像素坐标,两者承担不同的职责。
反过来,一个像素对应的归一化视线为 \(\mathbf q_i=K_i^{-1}\tilde{\mathbf p}_i\)。由于它的第三分量为 1,相机坐标中的点可以写成 \(\mathbf X_i=Z_i\mathbf q_i\)。从像素回到三维,缺少的正是标量 \(Z_i\);它是光轴方向的深度,沿射线的欧氏距离则是 \(Z_i\lVert\mathbf q_i\rVert\)。
实际镜头还包含畸变。后面的直线极线和矩阵投影都针对校正后的坐标;原始像素需要按相机模型去畸变或归一化。若图像缩放为原来的 \(s_x,s_y\),内参也必须相应变为 \(K'=\operatorname{diag}(s_x,s_y,1)K\)。本系列的平面扫描实验从宽 2,832 的照片生成宽 960 的图像时,正是同步处理了标定和畸变。
推导:齐次投影与相机之间的相对变换
给世界点补上齐次分量,\(\tilde{\mathbf X}=(\mathbf X^\top,1)^\top\),即可把投影合并为一个 \(3\times4\) 矩阵:
\[\tilde{\mathbf p}_i\sim P_i\tilde{\mathbf X}, \qquad P_i=K_i\begin{bmatrix}R_i&\mathbf t_i\end{bmatrix}.\]\(\sim\) 表示相差一个非零尺度,不能把齐次向量等同于未经归一化的像素坐标。
在参考相机 \(r\) 中,\(\mathbf X=R_r^\top(\mathbf X_r-\mathbf t_r)\)。代入支持相机 \(s\) 的变换,得到
\[\begin{aligned} \mathbf X_s &=R_sR_r^\top\mathbf X_r+\mathbf t_s-R_sR_r^\top\mathbf t_r\\ &=R_{sr}\mathbf X_r+\mathbf t_{sr}, \end{aligned}\]其中 \(R_{sr}=R_sR_r^\top\)、\(\mathbf t_{sr}=\mathbf t_s-R_{sr}\mathbf t_r\)。本系列中下标 \(sr\) 始终表示“从参考相机 \(r\) 的坐标变到相机 \(s\) 的坐标”。
下面只看一对照片,简写其相对变换为 \(\mathbf X_s=R\mathbf X_r+\mathbf t\)。由两次投影可得
\[Z_s\mathbf q_s=Z_rR\mathbf q_r+\mathbf t.\]这条式子将两幅图像、相对位姿和同一个场景点的深度连接起来,也是后续对极约束与平面扫描共同的出发点。
3. 视差与深度的尺度
先把两台相机放到一个便于计算的位置:它们朝向一致,第二台位于第一台右侧 \(B\),焦距相同,图像已校正且横向主点一致。此时 \(R=I\)、\(\mathbf t=(-B,0,0)^\top\)。门框点在两个图像中的横坐标分别满足
\[u_r=f\frac{X}{Z}+c_x, \qquad u_s=f\frac{X-B}{Z}+c_x.\]两式相减,横向视差 \(d=u_r-u_s=fB/Z\),于是
\[Z=\frac{fB}{d}.\]在焦距 1,200 像素、基线 0.5 米的教学配置里,60 像素的视差对应 10 米深度。将视差误测为 61 像素,会得到约 9.84 米;当视差只有 6 像素时,同样 1 像素的偏差会把 100 米变成约 85.7 米。这些数值用于解释几何,并不是城堡的实际米制标定。
对上式求导,可以把这种敏感性写得更明确:
\[\frac{\partial Z}{\partial d}=-\frac{fB}{d^2}, \qquad \sigma_Z\approx\frac{Z^2}{fB}\,\sigma_d.\]后一式是一阶误差传播,假定焦距和基线已知,视差误差足够小。它说明相同的像素定位误差会随距离产生更大的深度不确定性。扩大基线能够增强深度约束,同时也会增大遮挡和外观变化,所以城堡拍摄既需要相邻视图维持匹配,也需要不同观察位置提供有效视差。
这个双目配置是一般相机关系的特例。任意两张原图还包含旋转、不同主点和畸变,不能直接把原图横向位移代入 \(fB/d\)。恢复一般几何关系需要先保留前一节完整的相对投影式。
4. 从共同投影得到对极约束
回到 \(Z_s\mathbf q_s=Z_rR\mathbf q_r+\mathbf t\)。三条向量 \(\mathbf q_s\)、\(R\mathbf q_r\) 和 \(\mathbf t\) 共面,深度可以通过这个共面条件消去。用 \([\mathbf t]_\times\) 表示满足 \([\mathbf t]_\times\mathbf a=\mathbf t\times\mathbf a\) 的反对称矩阵,就得到
\[\mathbf q_s^\top E\mathbf q_r=0, \qquad E=[\mathbf t]_\times R.\]\(E\) 是本质矩阵。把 \(\mathbf q=K^{-1}\tilde{\mathbf p}\) 代回去,便得到像素坐标中的形式
\[\tilde{\mathbf p}_s^\top F\tilde{\mathbf p}_r=0, \qquad F=K_s^{-\top}EK_r^{-1}.\]\(F\) 是基础矩阵。固定参考图中的门框点后,\(\boldsymbol\ell_s=F\tilde{\mathbf p}_r\) 定义支持图中的极线;真正对应点应位于这条线上。原本的二维搜索因此受到一维几何约束。不过,线上的其他窗角仍可能外观相似,几何约束还需要与局部特征和鲁棒估计结合。
推导:消去深度、极点与本质矩阵的结构
令 \(\mathbf a=R\mathbf q_r\)。用 \(\mathbf t\times\mathbf a\) 对相对投影式两边取内积:
\[Z_s\mathbf q_s^\top(\mathbf t\times\mathbf a) =Z_r\mathbf a^\top(\mathbf t\times\mathbf a) +\mathbf t^\top(\mathbf t\times\mathbf a)=0.\]对非退化的有限可见点,便有 \(\mathbf q_s^\top[\mathbf t]_\times R\mathbf q_r=0\)。叉乘矩阵具体为
\[[\mathbf t]_\times= \begin{pmatrix} 0&-t_z&t_y\\ t_z&0&-t_x\\ -t_y&t_x&0 \end{pmatrix}.\]当 \(\mathbf t\ne0\) 时,\(E\) 的秩为 2,两个非零奇异值相等。除去整体尺度后,本质矩阵的有效自由度为 5,对应旋转的 3 个自由度和平移方向的 2 个自由度。基础矩阵则是满足秩 2 条件的齐次 \(3\times3\) 矩阵,有 7 个自由度。
参考相机中心在支持图中的投影为极点 \(\tilde{\mathbf e}_s\sim K_s\mathbf t\)。因为 \(\mathbf t^\top[\mathbf t]_\times=0\),所以 \(\tilde{\mathbf e}_s^\top F=0\),即所有支持图极线都经过这个极点。极点可以在图像外,也可以位于无穷远。
在只有原地旋转的情况下,\(\mathbf t=0\),上述本质矩阵变为零,无法提供三角化基线。平面场景也有特殊性:大量立面对应可能被一个单应矩阵解释,却未必能稳定确定一般三维结构。因此初始化需要同时检查模型支持和视差,不能只比较内点数量。
5. 对应点到相对位姿
计算时先从外观提出候选对应,再在含有外点的对应中估计 \(F\) 或 \(E\)。未知内参时常先估计基础矩阵;标定已知时,可以直接在归一化坐标上估计本质矩阵。RANSAC 反复拟合少量样本并检查其他对应,使错误窗户配对不至于直接主导整个模型。
一个对应对模型的偏离,可以用点到极线的距离衡量。常见的对称一阶近似是 Sampson 误差:
\[d_S^2= \frac{(\tilde{\mathbf p}_s^\top F\tilde{\mathbf p}_r)^2} {(F\tilde{\mathbf p}_r)_1^2+(F\tilde{\mathbf p}_r)_2^2 +(F^\top\tilde{\mathbf p}_s)_1^2+(F^\top\tilde{\mathbf p}_s)_2^2}.\]它把代数残差与极线的局部尺度联系起来,比只看分子更有几何意义。具体求解器可能采用不同的误差定义和阈值,不能直接将一个实现的“1 像素阈值”移到另一套残差上。
推导:归一化八点法与本质矩阵的位姿分解
对一组像素对应,把 \(F\) 按行展开为向量 \(\mathbf f\),约束可以写为
\[\begin{bmatrix} u_su_r&u_sv_r&u_s&v_su_r&v_sv_r&v_s&u_r&v_r&1 \end{bmatrix}\mathbf f=0.\]堆叠至少 8 组非退化对应得到 \(A\mathbf f=0\)。在有噪声时求 \(\min_{\lVert\mathbf f\rVert=1}\lVert A\mathbf f\rVert^2\),解是 \(A\) 最小奇异值对应的右奇异向量。先将两图坐标平移并缩放到合适数值范围,会改善条件数。若归一化变换为 \(T_r,T_s\),则反变换为 \(F=T_s^\top F_nT_r\)。
线性解不自动满足秩 2,需要对它做 SVD 并将最小奇异值置零。标定已知时,可进一步构造 \(E=K_s^\top FK_r\);将其奇异值投影成 \((a,a,0)\),其中 \(a\) 为前两个奇异值的平均值,使其满足本质矩阵结构。这只是入门的线性路线;标定相机的最小求解器也可以直接从更少的对应估计 \(E\)。
设 \(E=U\operatorname{diag}(a,a,0)V^\top\),并处理 \(U,V\) 的符号,使候选旋转满足行列式为 1。令
\[W=\begin{pmatrix}0&-1&0\\1&0&0\\0&0&1\end{pmatrix}.\]候选旋转来自 \(UWV^\top\) 和 \(UW^\top V^\top\),平移方向来自 \(\pm U_{:,3}\),组合成四个候选。对可靠对应进行三角化,选择使足够多点位于两相机前方的候选。平移长度仍然未知,常暂时令 \(\lVert\mathbf t\rVert=1\)。
相对位姿至此把两条归一化视线放进了共同坐标系。由于平移只有方向,没有外部长度参照时,场景与基线可以同时缩放而不改变投影。第三篇的两视图实验正是以单位基线表达深度;网页中的完整模型还另做了显示缩放,两者都不具有自动恢复的米制尺度。
6. 三角化与重投影
设两台相机的投影矩阵已经确定。每个观测都给出 \(\tilde{\mathbf p}_i\sim P_i\tilde{\mathbf X}\),因此 \([\tilde{\mathbf p}_i]_\times P_i\tilde{\mathbf X}=0\)。取每幅图中的两个独立约束,便能线性求一个齐次三维点。
对于城堡窗角,这相当于寻找同时贴近两条观测射线的空间位置。实际测量有噪声,两条射线通常并不精确相交;线性三角化提供初值后,可以继续最小化图像上的重投影误差:
\[\mathbf X^*=\arg\min_{\mathbf X} \sum_i\left\lVert \pi\!\left(K_i(R_i\mathbf X+\mathbf t_i)\right)-\mathbf p_i \right\rVert^2, \qquad \pi\begin{pmatrix}a\\b\\c\end{pmatrix}= \begin{pmatrix}a/c\\b/c\end{pmatrix}.\]这个目标在观测空间衡量误差,比线性方程中的代数残差更直接。若相机参数也参与优化,它就自然连接到下一篇的束调整。
推导:线性三角化的矩阵与正深度检查
记 \(P_i\) 的三行为 \(\mathbf a_{i1}^\top,\mathbf a_{i2}^\top,\mathbf a_{i3}^\top\)。除去投影尺度得到
\[(u_i\mathbf a_{i3}^\top-\mathbf a_{i1}^\top)\tilde{\mathbf X}=0, \qquad (v_i\mathbf a_{i3}^\top-\mathbf a_{i2}^\top)\tilde{\mathbf X}=0.\]将各图的约束堆叠为矩阵 \(A\),取其最小奇异值对应的右奇异向量。若最后一个齐次分量非零,就除以它恢复欧氏点;接近零则提示点可能非常远,不能直接当作稳定的有限三维点。
随后检查 \(Z_i=\mathbf e_3^\top(R_i\mathbf X+\mathbf t_i)>0\),并检查重投影误差与射线夹角。正深度只表示点位于相机前方;当射线几乎平行时,即使正深度和重投影误差都合理,深度仍然可能很不稳定。
从相机中心出发、在世界坐标中表达的射线方向为 \(R_i^\top\mathbf q_i\)。两条射线夹角较小时,微小的像素变化就会让交会位置大幅移动;这与前面 \(\sigma_Z\) 随距离增长的双目结论是一致的。初始化因此要保留足够视差,后续三角化也要筛除不可靠的点。
7. 从两视图走向城堡场景
到这里,我们已经把同一个门框点的两次图像观测写成相机模型、对极约束和三角化问题。加入更多照片后,局部对应需要合并成特征轨迹,新照片需要定位到已有三维结构,所有相机和点还要共同协调。这些操作组成 SfM,并为 MVS 提供相机几何。
上游日志记录了 11 个图像位姿、1 组共享内参、249,509 个特征和 55 个图像对;“1 组相机内参”不意味着只有一个拍摄位置。这次运行先初始化 8 个视图,再注册另外 3 张照片,其间穿插三角化、筛点和多次优化,最终导出 20,951 个稀疏点。具体初始化策略可以不同,但必须协调的几何量与本文一致。
沿着这条线索,第二篇将从实际特征匹配走到 PnP 和束调整;第三篇再把已知位姿代回相对投影式,推导平面诱导单应并估计稠密表面。
记号与参考。\(\mathbf X\) 为世界点,\(R_i,\mathbf t_i\) 为世界到相机变换,\(K_i\) 为内参,\(\mathbf q_i\) 为归一化视线,\(Z_i\) 为光轴深度,\(B\) 为基线,\(d\) 为校正双目的视差。更完整的投影与对极几何可参考 Hartley 与 Zisserman 的 Multiple View Geometry;具体相机模型及 recoverPose、triangulatePoints 接口见 OpenCV calib3d 文档。本文按上述约定独立展开公式,使用不同坐标约定的资料时需同步检查变换方向与符号。
数据与来源说明。完整城堡模型使用固定版本的上游结果,未在本次工作中重跑完整 SfM/MVS。原始哈希、数量与显示转换见数据清单,转换脚本为 prepare_reconstruction.py。上游仓库的 AGPL-3.0 授权原文随资源保留,具体材料使用条件以原始来源为准。
AI feedback
AnonymousLoading AI feedback…